
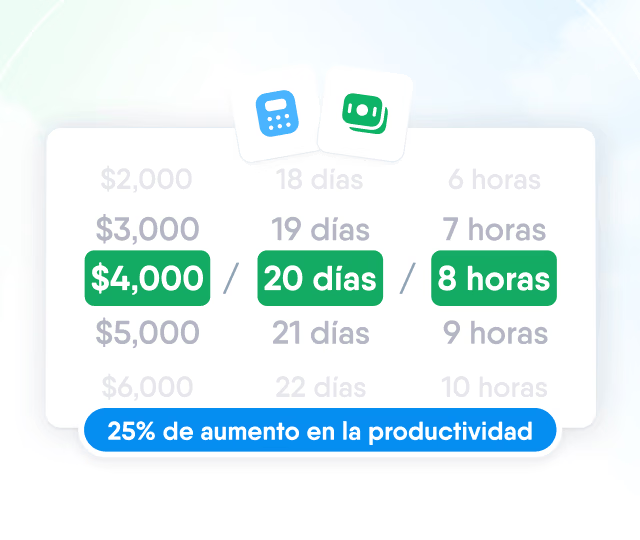
Estimador de Eficiencia de HR
Descubrí cómo funciona el Estimador de Eficiencia de HR de PeopleForce y calculá tu ahorro.
Calculá tu impacto


Calibración del desempeño
La calibración del desempeño es una reunión donde los líderes revisan juntos las calificaciones propuestas antes de cerrarlas, para que una misma calificación signifique más o menos lo mismo en todos los equipos.
La calibración del desempeño es una sesión de trabajo en la que un grupo de líderes, casi siempre con RRHH facilitando, revisa las calificaciones que piensa poner antes de que queden firmes. El objetivo no es cambiarle a nadie la opinión sobre su propio equipo. Es lograr que una calificación de supera expectativas signifique algo comparable, la haya puesto ventas o finanzas.
La necesidad nace de un hecho estructural de la evaluación de desempeño: cada líder califica a su propio grupo en aislamiento, con su escala interna. Algunos son estrictos, otros generosos, la mayoría se desplaza con el tiempo y ninguno ve cómo puntean sus pares. Sin un paso que compare entre grupos, la calificación del formulario describe al líder tanto como a la persona evaluada.
Por qué importa más de lo que parece
Las calificaciones rara vez son solo feedback. Alimentan decisiones de promoción, pago por desempeño, fondos de bonos y, en un mal año, decisiones sobre quién se queda. Si el líder de un área califica generoso y el de otra estricto, el equipo del primero recibe más dinero y más oportunidades por el mismo trabajo. Es un problema de equidad con una dimensión legal encima, y se acumula en silencio año tras año.
La calibración también atrapa los sesgos que un evaluador solo no ve en sí mismo: el efecto halo, la recencia, la tendencia a poner a todos en el medio seguro y patrones de sesgo inconsciente que solo aparecen cuando miras toda la población junta y no una evaluación por vez.
Cómo transcurre la sesión
Una sesión típica cubre un nivel o una función por vez, reúne entre cinco y diez líderes y dura dos o tres horas. Quien facilita abre con la distribución tal como está hoy, por equipo y por líder. Después la atención va a los casos atípicos y no a todo el mundo: las calificaciones más altas y más bajas, los líderes cuya dispersión no se parece al resto y las personas cuya calificación cambió bruscamente respecto del ciclo anterior.
Para cada uno, el líder aporta evidencia. Las preguntas que hacen el trabajo son simples. Qué hizo esta persona que no hizo alguien calificado un nivel por debajo. Le pondrías la misma calificación si trabajara en otro equipo. Qué tendría que haber sido distinto para el nivel siguiente. La calificación se sostiene si la evidencia aguanta y se mueve si no, y el cambio se registra con su motivo, para que el líder pueda explicárselo a la persona con sus propias palabras en lugar de informar que lo decidió un comité.
La distribución forzada es otra discusión
La calibración se confunde seguido con la distribución forzada, donde un porcentaje fijo de personas tiene que caer en cada banda. No son lo mismo. La calibración compara evidencia entre líderes; la distribución forzada le impone una forma al resultado sin importar la evidencia.
El argumento a favor de una distribución de referencia es que sin ella las calificaciones se inflan hasta que casi todos están por encima del promedio y la escala deja de informar. El argumento en contra es que los equipos reales no se distribuyen igual: un equipo chico que de verdad rindió bien se ve obligado a bajar a alguien, lo que rompe la confianza y hace que la gente evite los equipos más fuertes. La mayoría de las empresas que probaron ranking forzado estricto se alejaron de él. El punto medio que funciona es publicar una distribución esperada como referencia, pedir una explicación escrita cuando un equipo se aparta bastante y dejar que la explicación gane cuando es buena.
Qué separa una sesión útil de una negociación
- Manda la evidencia, no la elocuencia. Sin la regla de respaldar cada afirmación con un ejemplo concreto, gana quien mejor argumenta.
- Definiciones de calificación compartidas y escritas antes del ciclo. Si supera expectativas no está descrito en conductas por nivel, la sesión es gente comparando definiciones privadas.
- Un facilitador sin equipo propio en la sala. Suele ser RRHH, cuyo trabajo real es hacer la pregunta incómoda y mirar patrones por género, antigüedad, modalidad y ubicación.
- Calibrar antes de compartir resultados. Una calificación que llegó a la persona y después cambia cuesta más confianza que la inconsistencia que corrige.
- Anotar el motivo de cada cambio. La conversación posterior la sostiene el líder y sin el motivo no puede sostenerla.
Las fallas son la imagen espejo. Líderes sénior protegiendo a su gente y los más nuevos callados. El trueque, donde alguien acepta una baja a cambio de apoyo en otro lado. Sesiones tan largas que todo lo posterior a la primera hora lo decide el cansancio. Y la versión donde las calificaciones se ajustan en silencio después de la reunión por alguien que no estuvo en ella, que es la forma más rápida de lograr que los líderes dejen de tomarse el proceso en serio.
Cómo preparar la calibración con datos de PeopleForce
La calibración pasa en una sala, pero solo funciona si los números en pantalla son comparables de entrada. Para eso sirve el paso de puntuación en PeoplePerform: las preguntas de la evaluación se atan a competencias definidas en vez de a texto libre, cada competencia del ciclo lleva un peso explícito y la suma de los pesos tiene que dar 100 para que el ciclo avance. Todos los líderes puntean entonces las mismas competencias con la misma ponderación, lo que elimina el motivo más común por el que dos calificaciones no se pueden comparar.
Los insumos de la sesión están en el mismo lugar. Los resultados de cada persona se abren por grupo evaluador, con un gráfico de radar por competencia, así que una calificación de líder que queda muy por encima de la de pares y de la evaluación ascendente de la misma persona se ve antes de que alguien tenga que preguntar. La forma de compartir se controla a nivel del ciclo y puede quedar en manual, que es lo que permite calibrar antes de que los resultados lleguen a la gente y no después. Los ciclos tienen colaboradores además del dueño, así que RRHH puede trabajar dentro del ciclo durante la evaluación, y el ciclo puede bloquearse mientras tanto. Para la vista de distribución por área y por líder, la analítica de RRHH es donde aparece el patrón, incluida la comparación entre ciclos que te dice si un líder es generoso siempre o tuvo un trimestre atípico.


Mirá PeopleForce en acción
Desde Core HR hasta analítica avanzada de personas, descubrí cómo PeopleForce ayuda a los equipos a automatizar procesos y ahorrar hasta 80 horas al mes.